【はじめての性能試験 #2】非機能要件を「試験項目」に翻訳する ― 計画と設計の勘所
本シリーズ第2回です。第1回は、知識ゼロのインフラ担当が有識者やアプリチームに頼りながら性能試験を立ち上げるまで、どちらかというと心構えの話でした。今回からは、性能試験の中身の部分に触れていきます。まずは、計画と設計です。
性能試験で一番の肝になるのは、この「計画・設計」フェーズです。ここが固まっていないと、たとえばこんなことが起きます。
- スケジュール通りに進まなくなる
- 本来の目的からズレた試験を作り込んで、時間を無駄にする
- 「で、この結果はOKなの?」と、合否の判断がつかなくなる
出発点:非機能要件から「担保すべきこと」を言語化する
最初は、必須ではないものまで「あれもこれも測らないと」と詰め込んで、試験観点が膨らみすぎていました。第1回で触れた有識者のレビューで目的がはっきりしたことで、余分な観点を大幅に削れました。
「この試験で、最低限クリアすべきものは何か」。そう問い直すと、答えは至ってシンプルでした。非機能要件で約束している数字です。出発点はここだ、とようやく腹落ちしました。
まず、非機能要件に書かれた性能関連の項目を洗い出しました。内容は以下の通りです。
- オンラインレスポンス(通常時):5秒以下(遵守率90%)
- オンラインレスポンス(ピーク時):10秒以下(遵守率90%)
- ピーク負荷:通常時の約2倍を想定
- サービス時間:早朝〜深夜(この時間帯を「長時間稼働」の基準にした)
実は、主目的がこの非機能要件を満たすことだとすると、もう一つ、副目的がありました。スケーリングとサイジングを適切な値にフィックスすることです。この二つを軸にすると、「何を確かめ、どう扱うか」は次のように切り分けられました。
| 確かめること | 試験での扱い |
|---|---|
| レスポンス要件を満たすか(サービスレベル) | 合否の判定に使う(非機能要件に直結) |
| 満たせないとき、どの層が原因か切り分けられるか | スロークエリ・スケーリング・リソース使用率などの値を取り、ボトルネック調査で使う(合否には使わない) |
| エラー率などの品質シグナル | 速さそのものではないが、高いと品質問題。補助として取得する(合否には使わない) |
この「切り分け」を最初から組み込んでおいたことが、後の2段階戦略で効いてきます。
テスト対象を3つに分類する
システムを、性能特性の異なる3つの経路に分類しました。性能試験の負荷をどこに注ぐかを見極めるためです。
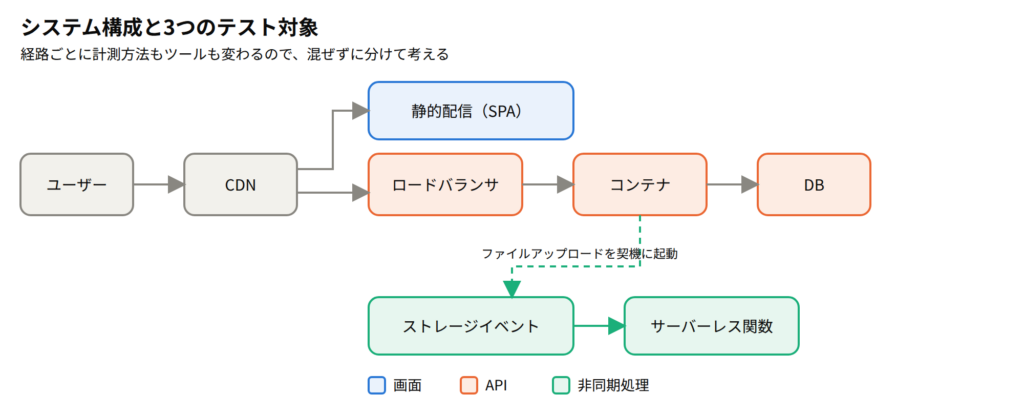
| 分類 | 経路 | 見るもの |
|---|---|---|
| 画面 | CDN → 静的配信(SPA) | フロントの表示速度(静的配信で負荷には強い) |
| API | CDN → ロードバランサ → コンテナ → DB | バックエンドのレスポンスとスループット |
| 非同期処理 | ストレージイベント → サーバーレス関数 | イベント駆動処理の実行時間とリソース消費 |
この3つのうち、負荷をかけて崩れるのはAPIです。画面は静的な資産をCDNから配信するだけなので、同時アクセスが増えても劣化しにくく、今回の負荷試験の対象からは外しました(体感速度が気になればLighthouseで一度見れば十分です)。非同期処理は、ユーザーが待つオンライン応答とは切り離されて動くため、今回の「レスポンス5秒以内」という要件には直接効きません。中身もアプリの実装に強く依存するので、この部分はアプリチームが別途計測しました。というわけで本シリーズでは、要件に直結し、いちばん作り込みが必要だったAPIテストに絞って扱います。
テスト種別:負荷の「かたち」で4つに分ける
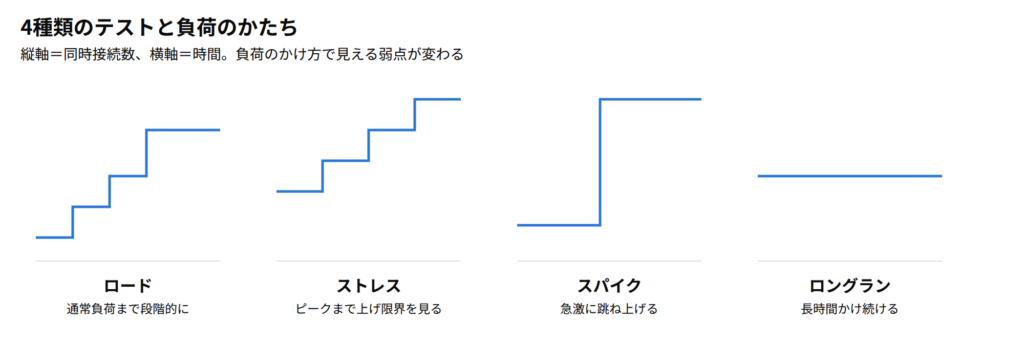
APIに対しては、負荷のかけ方の違いで4種類のテストを用意しました。同じシステムでも、負荷の「かたち」を変えると見えてくる弱点が変わります。
| テスト種別 | 負荷のかたち | 目的 |
|---|---|---|
| ロードテスト | 通常負荷まで段階的に増やす | 通常運用で要件を満たすか |
| ストレステスト | ピーク(通常の約2倍)まで上げる | ピーク時に耐えられるか・限界点はどこか |
| スパイクテスト | 急激に負荷を跳ね上げる | 突発的なアクセス増に耐えられるか |
| ロングランテスト | 一定負荷を長時間かけ続ける | メモリリークや性能劣化が起きないか |
ロードテストは同時接続数を数十から段階的に引き上げ、各段階を数分ずつ維持して計測します。ストレステストは通常負荷からさらにピークまで上げ、システムがどこで音を上げるか(限界点)を記録します。スパイクテストは、負荷を一気に跳ね上げ、急な増加にオートスケールが追いつけるか、追いつくまでの一時的な遅延やエラーから戻れるかを見ます。ロングランは、サービス時間に合わせて十数時間にわたって流し続け、時間経過でメモリやレスポンスが悪化しないかを見ました。
合格基準:平均ではなく「パーセンタイル」で決める
ここが計画のキモです。合格基準は、非機能要件に明記されている指標に加えて、「記載はないが重要だと判断した指標」もプロダクトオーナー(PO)と合意のうえで決めました。基準を先に握っておかないと、試験後に「この数字は合格なのか」で揉めます。
レスポンスタイムは、平均値ではなくパーセンタイルで見ます。平均で見ると、少数の遅いリクエストに引きずられて実態を隠すことがあるからです。今回は、非機能要件であるp90を軸に、参考値としてp50とp99も見ました。
| 指標 | 通常負荷 | ピーク負荷 |
|---|---|---|
| レスポンスタイム p50(中央値) | 参考値として記録 | 参考値として記録 |
| レスポンスタイム p90(要件・遵守率90%) | 5秒以下 | 10秒以下 |
| レスポンスタイム p99 | 記録して監視(外れ値の検知用) | 記録して監視(外れ値の検知用) |
| 5XXエラー率 | 1%未満 | 1%未満 |
3つは役割を分けて見ています。p90は要件そのもの(9割が5秒以内か=合否)。p99は、その要件の外側=いちばん遅い側を映します。9割が5秒以内でも、残り1割がどこまで遅いかは要件だけでは見えません。たとえばp90が5秒でもp99が30秒なら、「9割は5秒以内だが、いちばん遅い1%は30秒以上待っている」と分かります。p50は中央値で、外れ値に動じず分布の中心をとらえる目印。全体が底上げで遅くなっていないか(劣化の検知)に向きます。ユーザーの体験そのものではなく、分布が動いたかを見る指標、という位置づけです。そして、このp99で裾を見る見方が、第3回で触れる「p90を満たしていても、残り10%を無視してはいけない」という気づきにつながります。
ボトルネック調査は「DBから」── 試験の順序を設計する
初心者の私がいちばん「なるほど」と思ったのが、この試験の順序設計です。ただ全部を測るのではなく、「不合格だったときに原因を切り分けられる順序」で組む、という発想でした。
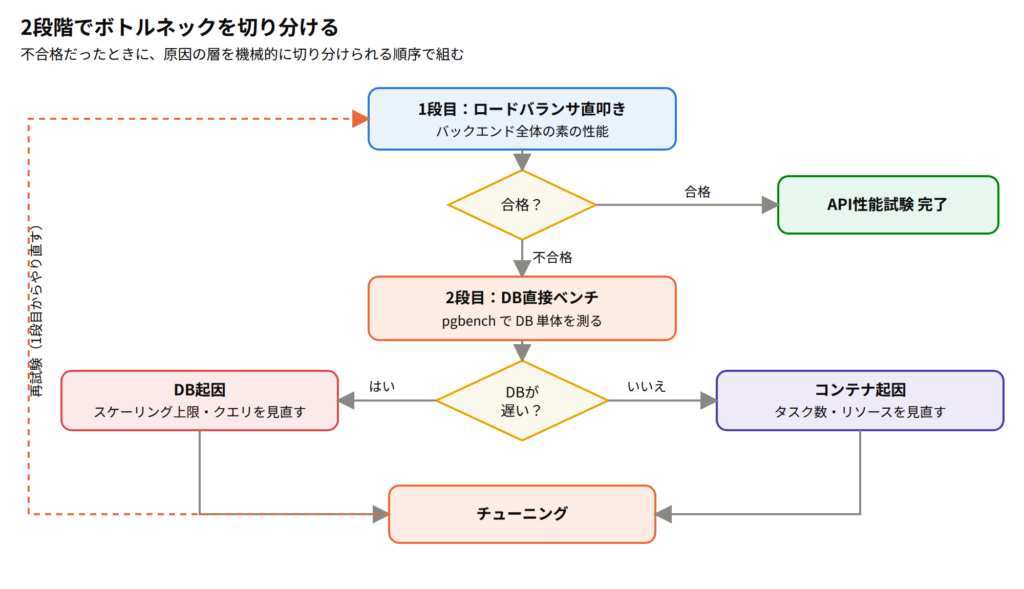
具体的にはこうです。
- 1段目:ロードバランサを直接叩く。 CDNなどを挟まず、バックエンド(コンテナ+DB)の素の性能を測ります。ここで合格すればAPI性能試験は完了。
- 2段目(1段目が不合格のとき):DBを直接ベンチマークする。 DB単体に負荷をかける専用ツール(pgbench)で、DB自体が遅いのかを確認します。
- DBで遅延 → DB起因 → スケーリング上限やクエリを見直す
- DBは正常 → コンテナ起因 → タスク数やリソース割り当てを見直す
- チューニング後、再び1段目から測り直す。
大事なことは、ボトルネック調査は、まず「DBから」。コンテナは台数を増やせば簡単にスケールできますが、その背後のDBは全コンテナが共有する一つの土台です。DBが詰まっていたら、コンテナをいくら増やしても無意味——全員が同じ遅いDBを待つだけ。コンテナのチューニングが活きてくるのは、土台のDBを解決してからです。
これは、遠回りして身にしみた結論でした。最初、私はコンテナのリソース使用率が異常に高いのを見て、まずタスク数を増やしました。ところが、結果はほとんど変わりません。腰を据えてDBを調べて、ようやく真因が見えました——アプリ側の設計と、DBのサイジングの両方に問題があったのです。コンテナをいくら足しても無駄だったわけで、ここでようやく「なぜDBからなのか」が腹落ちしました。
学び④:ボトルネックは、まず「DBから」疑う。水平スケールできるコンテナをいくら増やしても、土台のDB——アプリ設計とサイジング——が詰まっていれば徒労に終わる。だから性能試験は、不合格のときにDBから切り分けられる順序で組んでおく。
データ条件とウォームアップの扱い
どんなデータ量で測るかで結果は大きく変わります。当たり前ですが、空のDBで測っても何の役にも立ちません。大事なのは、本番稼働後もしばらくは性能が劣化しないと確認できる容量で測ること。つまり、将来の増加を見込んだデータ量を用意します。
どこまで見込むかは、システムによって変わります。想定される最大データ量での性能まで担保しないといけないのか、それともコストとのバランスで数年後の想定で十分とするのか——ここは判断が分かれます。だからこそ、測り始める前にPO(プロダクトオーナー)と握っておくことが大切です。今回は、かなり先の将来まで見込んだデータ量を、POと合意したうえで条件を定めました。
むしろ意外と見落とされがちなのが、キャッシュの状態です。ここも計測の条件として明示しました。
| 条件 | 状態 | 目的 |
|---|---|---|
| コールドスタート | キャッシュなし・DBバッファ未暖機 | 最悪ケースの参考値 |
| ウォームアップ後 | キャッシュあり・暖機済み | 定常運用時の性能(合否判定に使用) |
合否はウォームアップ後の値で判定し、コールドスタートは参考記録に留めました。ここを決めておかないと、たまたまキャッシュが冷えていた計測回だけ悪い数字が出て、判断が振れてしまいます。
まとめと次回予告
第2回では、非機能要件を「観点 → テスト対象 → テスト種別 → 合格基準 → 試験順序 → データ条件」へと段階的に翻訳していく流れを追いました。地味ですが、この設計の質が試験全体の質を決めます。
次回は実践編です。負荷ツールLocustで現実的なユーザーの負荷をどう作ったか(12本の混合シナリオ、権限別の読み書き比率)、そして手を動かして初めて分かった意外な落とし穴をお伝えします。負荷をかける側のスペック不足、レポートのパーセンタイル、長時間試験を途切れさせないための工夫。このあたりを、失敗も含めて正直に書くつもりです。