【はじめての性能試験 #3】「現実的な負荷」の作り方と、意外な落とし穴
本シリーズ最終回です。第1回で立ち上げ、第2回で計画と設計を固めました。今回は実践編。負荷ツールLocustで「現実的なユーザーの負荷」をどう作ったか、そして実際に手を動かして初めて分かった意外な落とし穴を書きます。
使ったツールと環境は次の通りです。
- 負荷ツール:Locust(Pythonでシナリオを書ける負荷試験ツール)
- 負荷生成環境:専用のEC2インスタンス(※スペックについては後述の落とし穴あり)
- 試験対象:本番と同一構成のステージング環境
- 監視:CloudWatch(コンテナのCPU/メモリ、DBのスケーリング状況など)
「現実的な負荷」とは何か
性能試験で意外と難しいのが、「本物っぽい負荷」を作ることです。全員が同じAPIを同じ間隔で叩くような負荷は、現実にはあり得ません。現実のユーザーは、閲覧が多い人・アップロードする人・管理操作をする人が入り混じり、画面を見て少し考えてから次の操作に移ります。
そこで意識したのが、次の3点です。
- 操作を「シナリオ」単位でまとめる:ログイン→フォルダ閲覧→ファイル詳細表示、のような一連の流れを1シナリオとする
- シナリオに「重み」をつける:よくある操作ほど出現頻度を高くする
- 操作の間に「考える時間」を挟む:ThinkingTime(待機)を入れて、人間の操作間隔を再現する
12本の混合シナリオを、アプリチームと組んだ
第1回で書いたとおり、アプリの操作実態はアプリチームに洗い出してもらいました。その結果、実際のユーザー動線に対応する12本ほどのシナリオを用意し、それぞれに出現頻度の重みを設定しました(下表は代表例)。
| シナリオ(代表例) | 操作の種類 | 重み(相対頻度) |
|---|---|---|
| 閲覧ユーザーの閲覧・ダウンロードURL取得 | 読み取り中心 | 高 |
| フォルダツリー取得後の深い階層の閲覧 | 読み取り中心 | 高 |
| メタデータ編集 | 読み書き混在 | 中 |
| アップロードURL生成・コールバック | 書き込み中心 | 中 |
| フォルダ作成・ファイル移動 | 書き込み中心 | 低 |
| 一括登録などの管理操作 | 重い書き込み | 低 |
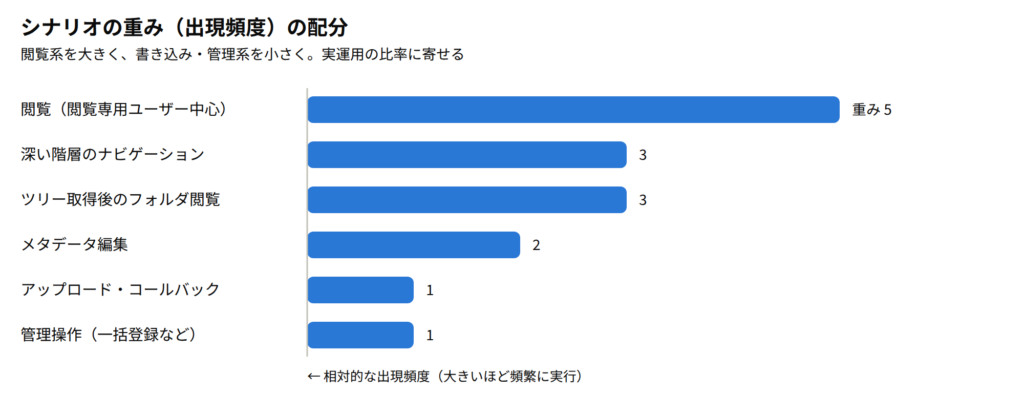
ポイントは、権限種別(閲覧のみ/編集可)とその人数比から、読み取りと書き込みの割合を決めたことです。閲覧専用ユーザーが多いシステムなら、負荷全体も読み取り寄りになる。この比率をアプリチームと詰めたことで、机上ではなくより実態に近い負荷になりました。
学び⑤:現実的な負荷は「重み × ThinkingTime × 権限別の読み書き比率」で作る。均一な負荷を全力で叩きつけるより、ばらつきを持たせた方が本番に近くなる。
負荷は「段階的に」上げる
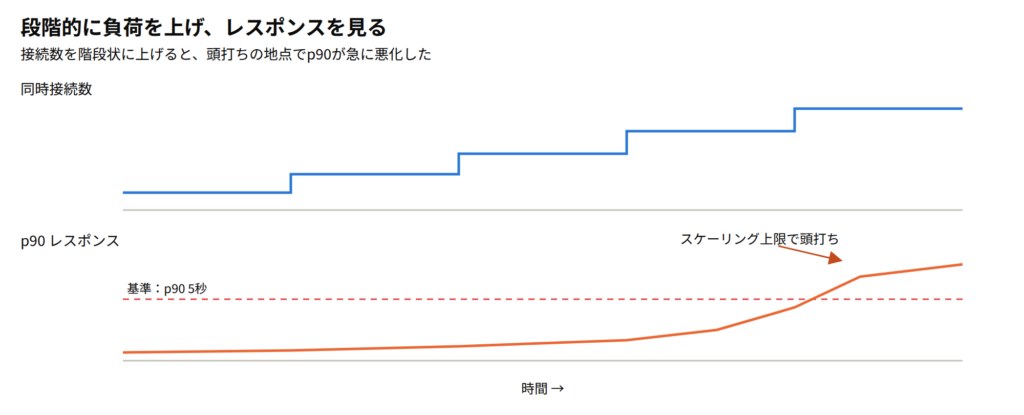
負荷は一気に最大までかけるのではなく、同時接続数を階段状に増やしていきました(Locustではカスタムの負荷カーブを定義できます)。各段階を数分ずつ維持し、レベルごとにレスポンスとリソース使用率を記録します。こうすると「どの接続数から性能が崩れ始めるか」がはっきり見えます。ストレステストではさらにピークまで上げ、スパイクテストでは途中で垂直に跳ね上げる、という具合に第2回で記載した4種類を使い分けました。
試験準備:実行の前に整えておく4つ
シナリオができても、それだけでは試験は流せません。第1回の全体像でいう「試験準備」、シナリオ設計と実行のあいだの工程です。実際に負荷をかけ始める前に、最低限そろえておいたのは次の4つでした。
| 準備するもの | 具体的にやったこと |
|---|---|
| 試験環境 | 本番と同一構成のステージングを対象にし、負荷をかける「側」にも十分なスペックのインスタンスを用意する |
| テストデータ | 運用5年後を想定したデータ量を投入し、ログイン用アカウントや操作対象(ファイル・フォルダ)を本番を想定してそろえる(データ条件の詳細は第2回) |
| シナリオの実装 | 設計した動線をLocustのコードに落とし込み、重みとThinkingTimeを設定して、小さく流して意図どおりにリクエストが飛ぶか確認する |
| 監視・計測の仕込み | 試験中にCPU・メモリ・DBのスケーリング状況・レスポンスを取れるよう、CloudWatchやレポート出力を事前にセットしておく |
地味な工程ですが、ここが甘いと「試験は流せたのに結果が信用できない」「途中で止まる」といった事故につながります。実際、このあと挙げる落とし穴の多くは、この準備の甘さが原因でした。負荷元のスペック不足(試験環境)、要件のパーセンタイルが出ないレポート設定(監視・計測の仕込み)、認証トークンの期限切れ(認証まわりの準備)。どれも、事前に潰しておけたはずのものです。
やってみて分かった、意外な落とし穴
計画も準備も整えたつもりでも、いざ流すと細かい問題が次々に出てきます。実際に詰まったポイントを並べます。
落とし穴①:負荷をかける「側」がボトルネックになった
最初、負荷生成用のインスタンスのスペックが低く、そもそも狙った高負荷をかけきれませんでした。ツールのグラフが頭打ちになるので「対象システムが限界か?」と一瞬思うのですが、実際には負荷元のCPUが先に振り切れていただけ。「測る対象」ばかり気にして、「測る側」の性能を見落としていました。シンプルにインスタンスサイズを上げて解決しました。
教訓:想定する最大負荷をかけきれるだけのスペックを、負荷生成側にも用意する。そのうえで、試験中は負荷元のリソース使用率も監視し、グラフの頭打ちが「対象の限界」なのか「負荷元の飽和」なのかを切り分けられるようにする。
落とし穴②:デフォルトのレポートが、要件のパーセンタイルに対応していなかった
非機能要件の基準はp90(90パーセンタイル)でした。ところがツールのデフォルトのレポート出力は別のパーセンタイル(p50やp99など)が中心で、肝心のp90がそのままでは出てきませんでした。レポートの出力設定を調整して、要件で使うパーセンタイルを取れるようにしました。
教訓:「要件で判定に使う指標が、ツールの標準出力に含まれているか」を着手前に確認する。出ないなら出力設定を変える。
落とし穴③:長時間試験が、認証トークンの期限で途切れる
十数時間流し続けるロングランテストで、途中からリクエストが失敗し始めました。原因は認証トークンの有効期限。デフォルトの有効期限(数十分)のままだと、試験の途中でトークンが切れ、以降のリクエストが軒並み認証エラーになっていたのです。
対策として、試験期間中だけトークンの有効期限を延長しました(もちろん試験完了後は元の値に戻します)。加えて、負荷を長く維持するにはセッションの持続時間の設定も見直す必要がありました。
教訓:長時間試験では「認証の有効期限 > 試験時間」を確認する。試験用に一時的に緩めた設定は、復旧手順とセットで管理する。
そして、指標の読み方で得た一番の学び
試験を重ねる中で、指標の解釈について大事な気づきがありました。非機能要件のp90を満たしていても、残り10%を無視していいわけではない、ということです。たとえばp90は5秒以内でも、その残り10%が数十秒待たされているなら、そのユーザーの不満やクレームに直結します。要件の数字の裏で、裾のユーザーに何が起きているかこそ注視すべきです。だからこそ、残り10%がどこまで遅くなってよいのか、その許容ラインをあらかじめPOと握っておくと、判断がぶれません。
関連して、瞬間的に目標値を満たさない場面もありました。悩ましいのは、「合格基準を割っているのだから対応すべきではないか」という点です。調べると、その劣化はごく限定的な場面でしか起きず、断続的にも再現しないと分かりました。ここで効いたのは、その扱いを自分たちだけで決めなかったことです。外れ値として扱ってよいと考えた根拠をPOに説明し、追加対応はしないという結論を合意しました。事前に決めた合格基準だけでは、こうした想定外のケースまでは読みきれません。例外が出たそのときに、扱いをきちんとPOと握るというのが後から揉めないポイントになります。
学び⑥:要件の数字をクリアすることがゴールではなく、実際に使う一人ひとりの体験を担保することがゴール。p90の「残り10%」から目を離さない。
シリーズのまとめ
全3回にわたって、知識ゼロのインフラ担当が初めて性能試験を主導した記録をお届けしました。振り返って一番効いたのは、独りで抱えなかったことです。資料を読み、有識者にレビューをもらい、アプリチームに操作の実態を出してもらう。この3つで的外れを避けられました。計画の段階で要件を観点に分解し、切り分けできる順序に組んだこと(第2回)と、実行フェーズで負荷元・レポート・認証の落とし穴を一つずつ潰したこと(第3回)は、その土台の上に乗っています。
今まさに初めての性能試験で迷子になっている人へ。最初は誰でも分からないことだらけです。頼れるものを頼って、余裕を持ったスケジュールで臨めば、乗り切れます。このシリーズが、その最初の一歩を少しでも軽くできると嬉しいです。
あわせて読む:番外編 性能試験でよく使う用語&観点の早見表(本シリーズで出てきた用語と、一般的な用語・観点をまとめた早見表です)