バックアップ HDD の「静かな死」を防ぐ仕組み ― smartctl でヘルスチェック
自宅のバックアップでよくあるのは、外付け HDD をもう 1 台つなぎ、毎晩 rsync などで複製しておく構成です。ただ、そのバックアップは、読まれないまま静かに壊れます。
バックアップ用のドライブは書き込まれるだけで、ほとんど読まれません。そのため、傷んでいても復元する日まで気づけない。これが「シュレディンガーのバックアップ」と呼ばれる定番の失敗です。
そこで私は、Raspberry Pi 5 につないだ外付け HDD 2 台を smartctl で毎晩・毎週・毎月ヘルスチェックしています。smartctl とは、HDD や SSD が記録している SMART(自己診断の情報)を読むコマンドです。また、セルフテストの開始も命じられます。
この記事でわかることは、次の 4 つです。
- smartctl で毎晩読む SMART 属性と、前日との差分での判定
- 短いセルフテストと拡張セルフテストの使い分けと所要時間
- rsync のバックアップが「動いているように見えて動いていない」状態の見つけ方
- 毎晩動かしている Python・シェルスクリプトと crontab
予備があることと、予備が使えることは別
2026 年は、空の便が止まるニュースが続きました。しかも、その 1 つは、まさに「予備が使えなかった」話です。
- 2026 年 9 月 21 日(米国): フィラデルフィアの進入管制施設で主回線が故障しました。ところが、切り替えた予備の光ファイバーは工事で切れていました。その結果、北東部の主要空港で離陸が止まり、1,000 便以上に影響しています。
- 2026 年 4 月 21 日(日本): 福岡航空交通管制部の不具合で、管制処理能力が低下しました。そして、東京の予備系に切り替えて復旧したものの 5 時間余りかかり、国内線 200 便以上が欠航しています。つまり、「切り替えられる」と「すぐ切り替えられる」は違います。
2023 年の事故: 予備が主系と同じ理由で壊れる型
また、2023 年にも似た型の事故がありました。例えば 8 月の英国の管制システムは、不正な飛行計画データで主系が止まり、予備系も同じデータで止まりました。さらに 1 月の米国 FAA では、同期中に壊れたファイルが予備側にもコピーされ、全米で離陸が止まっています。
どれも規模は違います。しかし、教訓は自宅のバックアップにそのまま当てはまります。
- 予備は、使う前に「使えること」を確かめる。確かめていなければ、予備ではない。
構成: Raspberry Pi 5 と外付け HDD 2 台を smartctl で診る
構成は単純です。まず、Raspberry Pi 5 に 4 TB の USB HDD を 2 台つなぎ、メインとバックアップにしています。そして、毎晩 02:00 に rsync で複製し、04:30 に smartctl を含む監査スクリプトが動きます。最後に、結果を Slack とダッシュボードに出します。
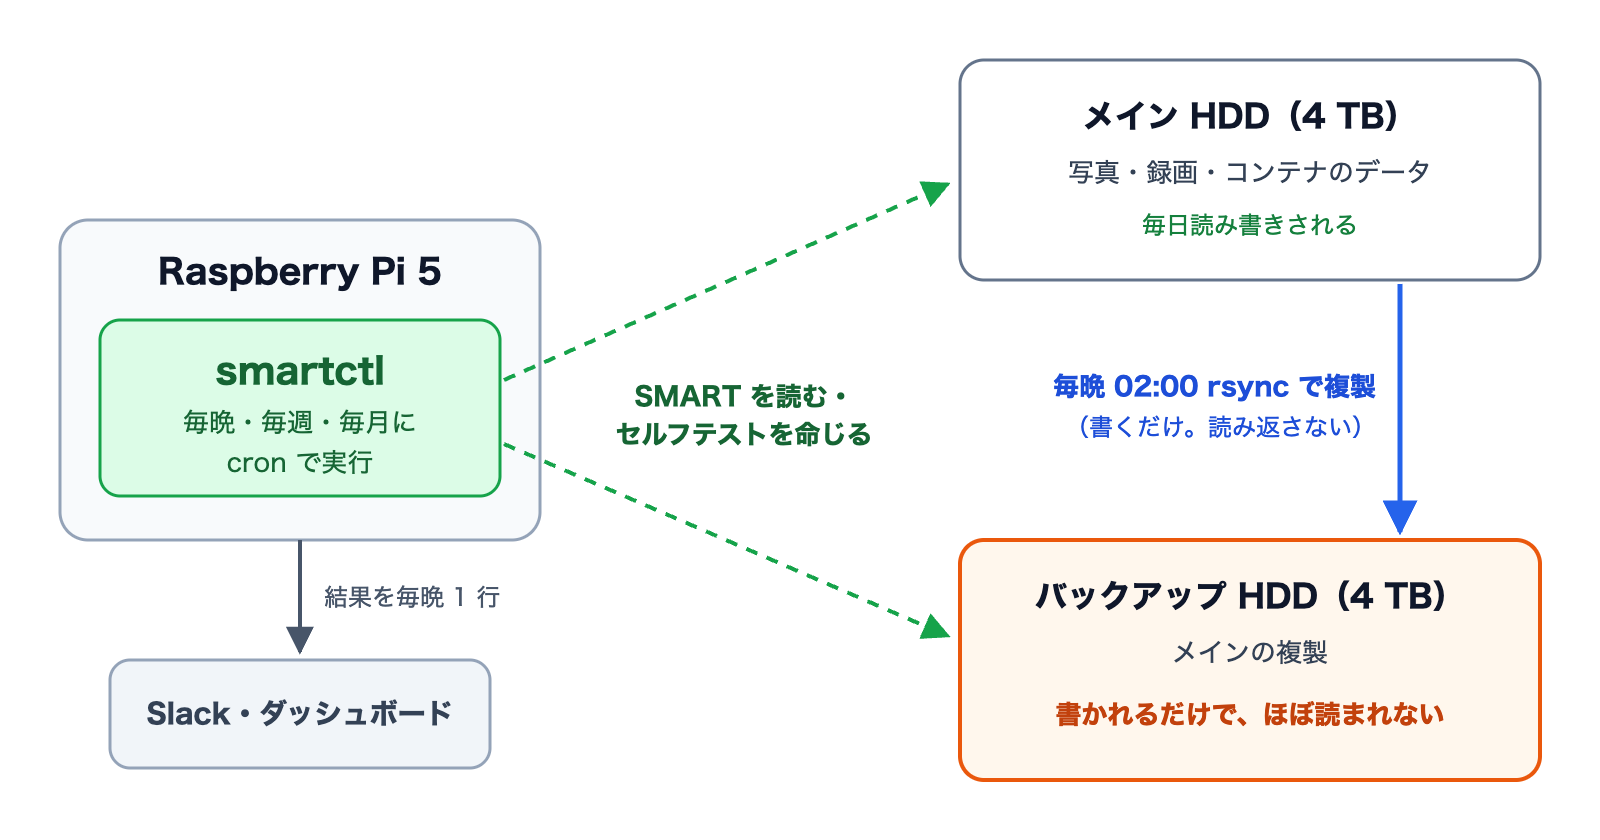
ポイントは 1 つだけです。バックアップ HDD は、放っておくと一度も読まれない。rsync は差分を書くだけで、読み返さないからです。そのため、読めない場所ができても誰も気づきません。よって、ヘルスチェックもそこに集中させます。
なお、自宅サーバーの外からの接続についてはWireGuard のオンデマンド接続の記事に、リバースプロキシについてはNginx Proxy Manager から Caddy に乗り換えた記事に書いています。
smartctl によるヘルスチェックの中身: 軽い検査を毎晩、重い検査を月 1 回
検査は、軽いものを高頻度に、重いものを低頻度にして層にしています。例えば、毎晩 8 時間の全面検査は確実ですが、HDD の寿命を縮め、電気代も無駄です。そこで、軽い検査で兆候を毎晩拾い、重い検査で実体を月 1 回確かめます。
検査の層と周期の一覧(表 1)
| いつ | 何をする | 負荷・時間 |
|---|---|---|
| 導入時(1 回) 新品を使う前 | 全面書き込み検査(badblocks -w)と拡張セルフテストで、初期不良をデータを載せる前に落とす。ただし中身が消えるので、新品限定 | 約 15 時間 + 8 時間 |
| 毎晩 04:30 | smartctl -x で SMART を全部読み、前日と比べる。さらに、2 台のマウント、今夜の複製、カーネルの I/O エラーも確認 | 1〜2 秒 / 台 |
| 毎週 日曜 04:00 | 短いセルフテスト(smartctl -t short)で、電気・機械系とごく一部の読み取りを自己診断。その結果は翌晩の読み取りで拾う | 1〜2 分 |
| 毎月 第 1 日曜 04:00 | 拡張セルフテスト(smartctl -t long)で全セクタを読み、「書けたのに読めない場所」を洗い出す。しかもデータは壊さず、使いながら実行できる | 約 8 時間(4 TB) |
毎晩: smartctl -x で SMART を「全部」読み、前日と比べる
SMART は、HDD 自身が記録している健康状態のカウンターです。例えば smartctl -x --json なら、属性、温度、通電時間、エラーログ、セルフテストの履歴まで一度に JSON で取れます。しかも読むだけなので負荷はなく、1 台あたり 1〜2 秒で終わります。
見ている属性は、具体的には次の 6 つが中心です。
毎晩見ている 6 つの SMART 属性(表 2)
| ID | 名前 | 意味 | どう判定しているか |
|---|---|---|---|
| 197 | Current_Pending_Sector | 読めなくて代替待ちのセクタ | 1 でも赤(今まさに読めない場所がある) |
| 198 | Offline_Uncorrectable | 訂正できなかったセクタ | 1 でも赤 |
| 5 | Reallocated_Sector_Ct | 予備領域に振り替えたセクタ数 | 0 以外は黄、前日から増えたら赤 |
| 187 | Reported_Uncorrectable | データを返せなかった読み出しの回数 | 0 以外は黄、前日から増えたら赤 |
| 199 | UDMA_CRC_Error_Count | 転送路(ケーブル・USB 変換基板)のエラー | 増えたら黄(ドライブではなく接続を疑う) |
| 188 | Command_Timeout | 応答待ち切れ | 増えたら黄(電源・ケーブルを疑う) |
絶対値より、前日からの差分を重く見る
SMART の生の値は、メーカーごとに意味が違います。例えば Seagate の読み出しエラー率は、巨大な数字でも正常です。しかし「昨日 0 の代替処理済みセクタが今日 3」は、どのメーカーでも異変です。そこで、毎晩の結果をシリアル番号ごとに保存し、翌晩に引き算をします。その結果、じわじわ進む劣化を最初の一歩で捕まえられます。
属性のほかに smartctl の JSON から拾うもの
また、同じ JSON から次も拾います。
- 総合判定(smart_status.passed): FAILED は「もうすぐ壊れる」という自己申告なので、赤。
- 正規化値と閾値: Pre-fail 属性が閾値を割れば、生の値に関係なく赤。いわば、メーカーが定義した「警告灯」です。
- 温度: 50 ℃ 超で黄、動作上限(55〜60 ℃)超で赤。なお、外付けケースの中は想像より熱くなります。
- セルフテストの履歴: 週次・月次の結果を翌晩に拾います。また、失敗なら赤、10 日以上走っていなければ「仕組みが止まっている」と知らせます。
- 通電時間: 5 年超で「交換を考え始める」、7 年超で「いつ壊れてもおかしくない」として黄。
- デバイス統計(GP Log): Reported Uncorrectable Errors などは、属性表に出ないドライブでもここに出ることがあります。
毎晩: rsync のバックアップが本当に走ったかを疑う
ドライブが元気でも、バックアップが走っていなければ意味がありません。しかも、スクリプトは「動いているように見えて動いていない」状態に簡単になります。例えば、私が実際に踏んだのは次の 2 つです。
- バックアップ HDD を抜いたままにしたら、rsync は空のマウント先(つまり SD カード)に 1.5 TB を書こうとした。
- メイン HDD が外れた状態で rsync --delete が走ると、空の元ディレクトリを忠実に複製し、バックアップを全部消す。
しかし、どちらも rsync は正常終了し、ログには「done」と出ます。そこで、スクリプトの冒頭で両方のマウントを確かめ、無ければ何もせずに通知だけして終わるようにしました。
#!/bin/sh
# 両方マウントされていなければ何もしない(空のディレクトリを複製すると事故になる)
if ! mountpoint -q /mnt/backup || ! mountpoint -q /mnt/main; then
  curl -s -X POST -H 'Content-type: application/json' \
    --data '{"text":"backup skipped: main or backup is not mounted"}' "$SLACK_WEBHOOK_URL" > /dev/null
  exit 0
fi
rsync -aHAX --delete /mnt/main/ /mnt/backup/ 2> /var/log/backup/rsync_errors.log \
  || curl -s -X POST -H 'Content-type: application/json' --data '{"text":"rsync error"}' "$SLACK_WEBHOOK_URL"
スクリプトとは独立に見る 4 項目
さらに、毎晩のヘルスチェックはスクリプトとは独立に次を見ます。
- 2 台ともマウントされているか。ただ、USB の外付けは「df には出るのに読むと I/O エラー」にもなるので、実際に statvfs を打って確かめます。
- rsync のエラーログの更新時刻が 30 時間以内か。つまり、古ければ走っていない。また、サイズが 0 でなければ何かが複製できていない。
- ディスクの使用率が 90% を超えていないか。
- 24 時間以内のカーネルログに I/O error や USB リセットが無いか。なお、SMART より先に OS 側が悲鳴を上げることがあります。
毎週: smartctl -t short で短いセルフテスト(1〜2 分)
SMART のセルフテストは、HDD が自分自身を検査する機能です。つまり、smartctl で「始めて」と命じれば、あとはドライブ内部が進めます。また、データは書き換えないので、マウントしたまま実行できます。
短いテスト(smartctl -t short)は 1〜2 分で、電気系・機械系の自己診断と、ごく一部の読み取りを行います。そのため負荷が小さく、毎週日曜に入れています。ただし、月の最初の日曜だけは拡張テストにします。
毎月: smartctl -t long の拡張セルフテストで全セクタを読む
そして、ここがこの仕組みの核心です。
よくある誤解に「書けたのだから読める」があります。しかし HDD の磁気記録は時間とともに弱まり、書いた時は正常だったセクタが後から読めなくなることがあります。これを潜在セクタエラー(latent sector error)と呼びます。例えば SMART の代替待ちセクタ(197)は、読もうとして失敗して初めて増えます。つまり、読まなければずっと 0 のままです。
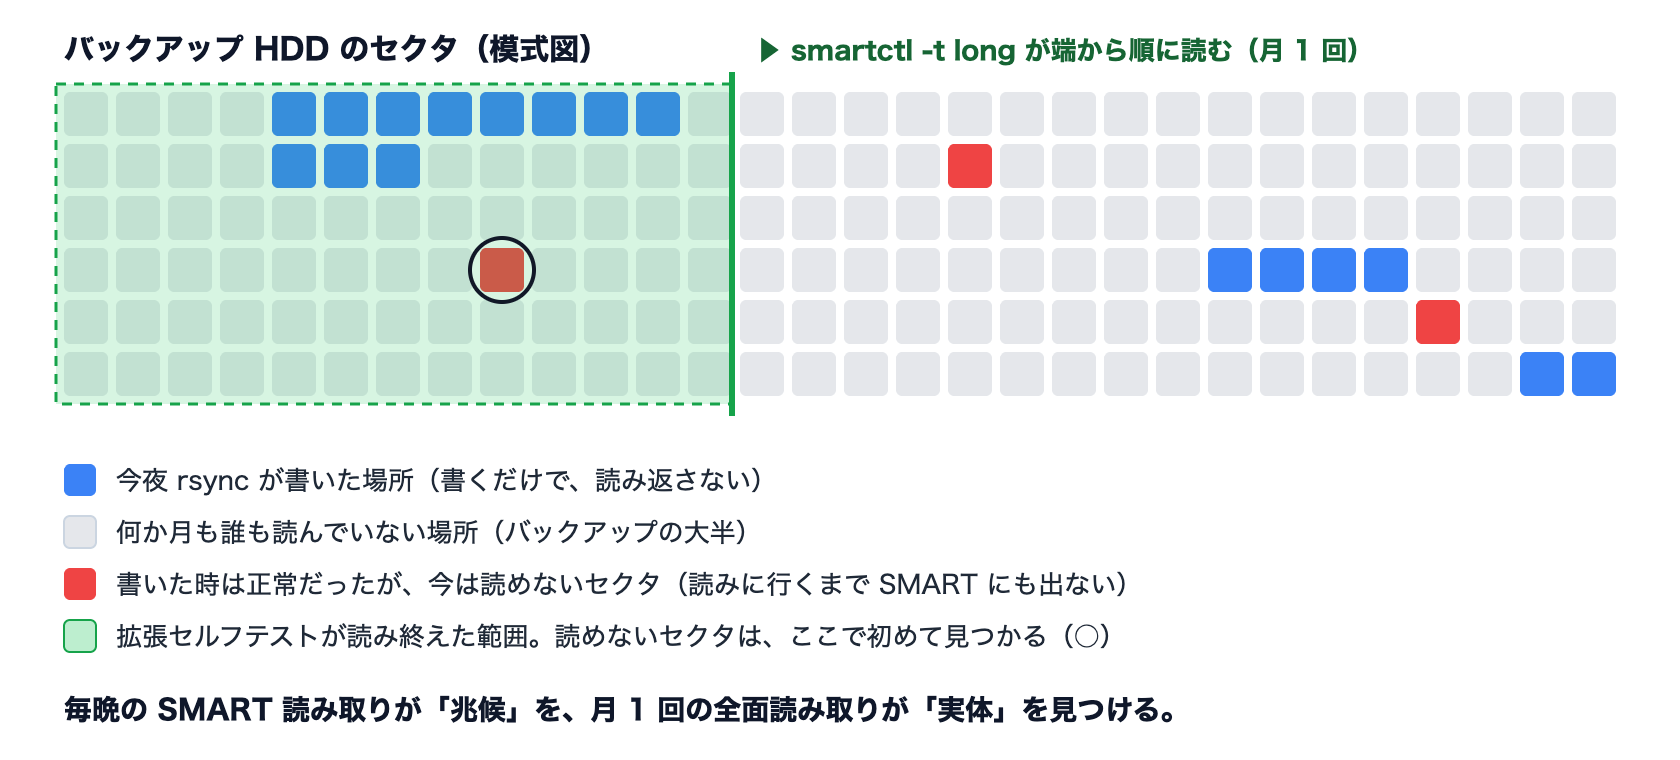
拡張セルフテストの所要時間と注意点
拡張セルフテスト(smartctl -t long)では、ドライブが全セクタを端から端まで読みます。4 TB の USB HDD で約 8 時間です。しかも、データは消えず、使いながら実行できます(I/O があると一時停止し、その分長引きます)。そして、結果はドライブ内に残るので、翌晩の読み取りで「Completed without error」かが分かります。
数字で感覚をつかんでおきます。民生用 HDD の読み取り不能エラー率は、仕様書では一般に「1014 ビットに 1 回」です。一方、4 TB は約 3.2×10¹³ ビットなので、全面を 1 回読むと計算上 0.3 回ほど当たります。つまり数回に 1 回は当たるオーダーです。実際の良品はずっと優秀ですが、全面の読み返しは気休めではありません。
導入時: 新品 HDD は badblocks で検査してから使う
HDD の故障は、使い始めと寿命末期に集中します(バスタブ曲線)。そのため新品は、データを載せる前に一度だけ重い検査をします。
# 中身が全部消える。新品、または消してよいドライブにだけ実行する
sudo badblocks -wsv -t random -b 4096 /dev/sdX

# 0 件なら続けて拡張セルフテスト(ドライブ自身の全面読み取り)
sudo smartctl -t long -d sat /dev/sdX
# 翌日
sudo smartctl -l selftest -d sat /dev/sdX
badblocks -w は全面にパターンを書いて読み戻す検査で、4 TB で約 15 時間です。また、USB ケーブルや変換基板を含む経路全体を調べるので、セルフテストとは見る場所が違います。そのため、両方通れば初期不良はほぼ無いと言えます。なお、中身が消えるうえ、15 時間のフル稼働は古いドライブに引導を渡しかねません。つまり、古いドライブには拡張セルフテストで十分です。
smartctl の定期チェックで守れること、守れないこと
「万全」とは言いたくないので、何を守れていて何を守れていないかを正直に書きます。
守れていること: 予兆から監視の死まで
- ドライブの予兆: 総合判定・閾値割れ・代替処理の増加・温度を、前日との差分で見る。
- 読めない場所: 月 1 回の全面読み取りで、SMART に出ない潜在セクタエラーを洗い出す。
- 仕組みの死: 走ったか、エラーが出たか、2 台が見えているか。ドライブが元気でも、止まっていれば赤。
- 接続の劣化: CRC エラーとタイムアウトで、ケーブル・変換基板・電源を切り分ける。しかも、USB 外付けの不調の半分はここです。
- 監視の死: 正常でも毎晩 1 行、Slack に出す。「通知が来ない=正常」だと、監視が止まっても気づけないからです。
SMART だけに頼らない理由(Google と Backblaze の統計)
SMART だけに頼らないのは、Google が 10 万台規模で調べた 2007 年の論文で、故障ドライブの 36% に SMART の兆候が無かったからです。また、Backblaze の集計でも、主要 5 属性に兆候が出ないまま壊れたドライブが 2 割ほどありました。つまり SMART は、「出たら本物」だが「出ないから安全」ではない。そのため、全面読み取りと仕組み側の検査を重ねています。
守れていないこと: 論理的な破壊・無言の破損・同時に失う事故
- 論理的な破壊: 誤って消したファイルや暗号化されたファイルも、rsync --delete が翌晩に忠実に運びます(FAA の事故と同じ型)。一方、これには世代管理(スナップショットや --backup-dir)が効きます。
- 無言の破損(silent corruption): エラーにならずに中身だけ化けると、全面読み取りでも見つかりません。そのため、ZFS・Btrfs の scrub か、ハッシュの照合が要ります(後述の予行演習)。
- 同時に失う事故: 火事・盗難・落雷では、同じ机の 2 台が同時に死にます。よって、これはオフサイトのコピー(3-2-1 ルールの「1」)の仕事です。
- SD カード: Pi 本体の SD には SMART がありません。そこで、重要な設定や DB は HDD 側へ毎晩書き出し、監視に相乗りさせています。
つまりこの仕組みは、「復元しようとした日に、ドライブが読めない」という最も悔しい失敗を狙い撃ちにしたものです。
使っているツールと、毎晩動かすスクリプト
ツール一覧: smartctl(smartmontools)・badblocks・rsync
smartctl は smartmontools パッケージに入っており、Raspberry Pi OS なら sudo apt install smartmontools で導入できます。ほかのツールも、標準で入っているか apt で入るものです。
| ツール | 何を確認するか | 負荷 |
|---|---|---|
| smartmontools(smartctl) | SMART 属性・温度・エラーログ・セルフテストの実行と結果 | 読むだけなら無し |
| badblocks(e2fsprogs) | 新品の全面書き込み・読み戻し検査 | 最大(新品限定) |
| mountpoint / findmnt / lsblk | マウントされているか、どのデバイスがどこか | 無し |
| rsync(-n --itemize-changes、-c) | 複製の差分がゼロか、必要なら中身まで比較 | -c は全読み |
| journalctl -k | カーネルの I/O エラー・USB リセット | 無し |
| tune2fs / e2fsck | ext4 のエラー回数、異常時の挙動(errors=remount-ro) | 読むだけなら無し |
| cron + curl(Slack Webhook) | 毎晩動かす、結果を届ける | 無し |
手で確かめるときの smartctl コマンド
# どのデバイスがどのドライブか(USB は差し直すと名前が変わるので毎回確かめる)
lsblk -o NAME,SIZE,MODEL,SERIAL,MOUNTPOINT

# 総合判定だけ
sudo smartctl -H -d sat /dev/sda

# 属性の表(人間向け)
sudo smartctl -A -d sat /dev/sda

# 全部を JSON で(スクリプトはこれを読む)
sudo smartctl -x --json -d sat /dev/sda | jq '.smart_status, .temperature, .power_on_time'

# セルフテストの開始と結果
sudo smartctl -t short -d sat /dev/sda     # 1〜2 分
sudo smartctl -t long  -d sat /dev/sda     # 4 TB で約 8 時間
sudo smartctl -l selftest -d sat /dev/sda  # 履歴(Completed without error / read failure)

# 複製に差分が残っていないか(何も書かない)
rsync -aHAXn --delete --itemize-changes /mnt/main/ /mnt/backup/ | head

# 直近 24 時間のカーネルの悲鳴
journalctl -k --since -24h | grep -iE 'I/O error|medium error|uas|reset'

# ext4 が記録したエラー回数と、異常時の挙動
sudo tune2fs -l /dev/sda1 | grep -iE 'error|mount count'
-d sat は、USB 変換基板越しに SATA の SMART を読むための指定です。付けなくても読める基板もあるので、スクリプトでは付けて失敗したら外す順で試しています。
毎晩動かすスクリプト(Python 3、標準ライブラリのみ)
実際に使っているものを、この記事用に 1 ファイルにまとめ直しました。しかも、Python 3 の標準ライブラリだけで動きます。処理は「SMART を読む → 前回と比べる → マウント・複製の鮮度・カーネルログを見る → Slack へ 1 行」です。
#!/usr/bin/env python3
# storage-health.py — 毎晩 1 回。SMART を読んで前回と比べ、マウント・複製の鮮度・カーネルログを確かめ、結果を Slack へ 1 行
import json, os, subprocess, time, urllib.request

DRIVES  = ['/dev/sda', '/dev/sdb']                  # lsblk で確かめたデバイス
MOUNTS  = {'/mnt/main': 'メイン', '/mnt/backup': 'バックアップ'}
RSYNC_ERR = '/var/log/backup/rsync_errors.log'      # バックアップが毎回書き直すエラーログ
STATE   = '/var/lib/storage-health/last.json'       # 前回の SMART(シリアル番号ごと)
WEBHOOK = os.environ.get('SLACK_WEBHOOK_URL', '')
TRACK = {5: '代替処理済みセクタ', 187: '訂正できなかった読み出し', 188: 'コマンドのタイムアウト',
         197: '代替待ちセクタ', 198: '訂正不能セクタ', 199: 'CRC エラー(ケーブル)'}

def run(cmd, timeout=90):
    return subprocess.run(cmd, capture_output=True, text=True, timeout=timeout).stdout

def smart(dev):
    for opt in (['-d', 'sat'], []):                   # USB 変換基板越しは -d sat、だめなら素で
        try: j = json.loads(run(['smartctl', '-x', '--json', *opt, dev]) or '{}')
        except json.JSONDecodeError: j = {}
        if j.get('ata_smart_attributes'): return j
    return {}

crit, warn, info = [], [], []
prev = json.load(open(STATE)) if os.path.exists(STATE) else {}
now = {}

for dev in DRIVES:
    j = smart(dev)
    if not j: warn.append(f'{dev}: SMART を読めない'); continue
    sn = j.get('serial_number', dev); name = f"{dev}({j.get('model_name', '?')})"
    attrs = {str(a['id']): a['raw']['value'] for a in j['ata_smart_attributes']['table']}
    now[sn] = attrs; old = prev.get(sn, {})
    if not (j.get('smart_status') or {}).get('passed'): crit.append(f'{name}: SMART 総合判定 FAILED')
    for a in j['ata_smart_attributes']['table']:    # 正規化値が閾値割れ(ドライブ自身の警告灯)
        if a.get('when_failed') == 'now': crit.append(f"{name}: {a['name']} が閾値を割っている")
    for i in ('197', '198'):                         # 今読めないセクタは 1 でも赤
        if attrs.get(i): crit.append(f'{name}: {TRACK[int(i)]} {attrs[i]}')
    for i, label in TRACK.items():                   # 前回からの増加
        d = attrs.get(str(i), 0) - old.get(str(i), 0)
        if d > 0: (crit if i in (5, 187, 197, 198) else warn).append(f'{name}: {label} が前回から +{d}')
    t = (j.get('temperature') or {}).get('current')
    if t and t >= 50: warn.append(f'{name}: 温度 {t} ℃')
    poh = (j.get('power_on_time') or {}).get('hours') or 0
    if poh >= 7 * 8766: warn.append(f'{name}: 通電 {poh / 8766:.1f} 年')
    log = j.get('ata_smart_self_test_log') or {}
    tests = ((log.get('extended') or log.get('standard') or {}).get('table')) or []
    if tests:
        last = tests[0]
        if last['status'].get('passed') is False: crit.append(f"{name}: セルフテスト失敗 {last['type']['string']} / {last['status']['string']}")
        elif (poh - last['lifetime_hours']) % 65536 > 24 * 10: info.append(f'{name}: セルフテストが 10 日以上走っていない')
        else: info.append(f"{name}: 直近のセルフテスト {last['type']['string']} = {last['status']['string']}")
    else: info.append(f'{name}: セルフテストの履歴なし')

for path, label in MOUNTS.items():                   # マウント。df に出ていても読めない状態を statvfs で弾く
    try:
        if not os.path.ismount(path): raise OSError('not mounted')
        os.statvfs(path)
    except OSError as e: crit.append(f'{label} がマウントされていない({e})')

if os.path.exists(RSYNC_ERR):                        # 複製の鮮度とエラー
    age = (time.time() - os.stat(RSYNC_ERR).st_mtime) / 3600
    if age > 30: warn.append(f'バックアップが {age:.0f} 時間走っていない')
    if os.stat(RSYNC_ERR).st_size: warn.append('rsync がエラーを記録している')
else: warn.append('rsync のログが無い(一度も走っていない)')

kmsg = run(['journalctl', '-k', '--since', '-24h', '-q', '-g', 'I/O error|medium error|UAS|reset']).strip().splitlines()
if kmsg: warn.append(f'カーネルログに I/O エラー等 {len(kmsg)} 行')

os.makedirs(os.path.dirname(STATE), exist_ok=True)
json.dump(now, open(STATE, 'w'))                     # 次回の比較用

icon = '🔴' if crit else '🟡' if warn else '🟢'
text = f'{icon} storage-health: ' + (' / '.join(crit + warn) if crit or warn else '異常なし') + '\n' + '\n'.join(info)
print(text)
if WEBHOOK:                                          # 正常でも毎晩 1 行。来ない日は監視側が死んでいる
    req = urllib.request.Request(WEBHOOK, json.dumps({'text': text}).encode(), {'Content-Type': 'application/json'})
    urllib.request.urlopen(req, timeout=10)
セルフテストを命じるシェルスクリプトと crontab
セルフテストを命じる側は、短いシェルスクリプトです。具体的には、月の最初の日曜だけ拡張テスト、ほかの日曜は短いテストにしています。なお、cron に曜日と日付を両方書くと「どちらかに一致すれば実行」になるため、判定はスクリプトの中で行います。
#!/bin/sh
# smart-selftest.sh — 日曜に実行。月の最初の日曜は拡張テスト、それ以外は短いテスト
if [ "$(date +%d)" -le 7 ]; then T=long; else T=short; fi
for dev in /dev/sda /dev/sdb; do
  smartctl -t $T -d sat "$dev" > /dev/null 2>&1 || smartctl -t $T "$dev" > /dev/null 2>&1
done
echo "smart self-test ($T) started: $(date)"
# root の crontab(crontab -e)
SLACK_WEBHOOK_URL=https://hooks.slack.com/services/XXXX/YYYY/ZZZZ

0  2 * * *  /usr/local/bin/backup.sh                 # 複製
30 4 * * *  /usr/local/bin/storage-health.py         # 毎晩の読み取りと比較
0  4 * * 0  /usr/local/bin/smart-selftest.sh         # 日曜: 短い / 第 1 日曜: 拡張(結果は翌晩に拾う)
順番にも意味があります。例えば、複製(02:00)の後に読み取り(04:30)を動かせば、複製中の CRC エラーやタイムアウトをその晩に拾えます。また、セルフテストは日曜 04:00 に始め、結果は月曜 04:30 に確認します。なお、拡張テスト中は静かにしておくのが理想ですが、使っても壊れはしません。
月 1 回の「復元の予行演習」: 無作為なファイルのハッシュを比べる
ドライブが読めても、中身が同じかは別問題です。そこで、月 1 回、無作為に選んだファイルを両方から読んで比べています。ただ、全部比べる(rsync -c)と 4 TB で丸 1 日かかるので、標本検査です。
#!/bin/sh
# restore-drill.sh — 無作為に 200 ファイル選び、メインとバックアップのハッシュを比べる
cd /mnt/main || exit 1
find . -type f -size +1k 2>/dev/null | shuf -n 200 | while read -r f; do
  a=$(sha256sum "$f" | cut -c1-64); b=$(sha256sum "/mnt/backup/$f" 2>/dev/null | cut -c1-64)
  [ "$a" = "$b" ] || echo "MISMATCH: $f"
done | tee /var/log/backup/restore-drill.log
[ -s /var/log/backup/restore-drill.log ] && echo "restore drill: mismatches found" || echo "restore drill: 200/200 OK"
200 ファイルで不一致がゼロなら、バックアップ全体が壊れている確率はかなり低いと言えます。逆に 1 つでも出たら、その日のうちに原因を追います。いわば「予備回線に切り替えてみる」訓練の自宅版です。
smartctl と HDD のヘルスチェックに関するよくある質問
smartctl で USB 外付け HDD の SMART が読めないときは?
まず -d sat を付けて試してください。ただし、USB-SATA 変換基板によっては SMART を通さないものもあり、その場合はケースを替えるしかありません。
拡張セルフテストは、どのくらい時間がかかりますか?
4 TB の USB HDD で約 8 時間です。また、データは消えず、マウントしたまま実行できます。ただし、実行中に I/O があると一時停止するので、その分長引きます。
smartctl のヘルスチェックで、HDD の寿命は縮みませんか?
毎晩の SMART 読み取り(1 台 1〜2 秒)と週 1 回の短いテスト(1〜2 分)は、寿命に響くほどの負荷ではありません。一方、月 1 回の拡張テストは全面を約 8 時間読むので、相応の負荷があります。そのため、毎晩ではなく月 1 回にとどめ、書き込みを伴う badblocks -w は新品の導入時だけにしています。
SMART のどの値が出たら、ドライブを交換すべきですか?
総合判定が FAILED、Pre-fail 属性の閾値割れ、代替待ちセクタ(197)や訂正不能セクタ(198)が 1 以上なら、交換を考えます。また、代替処理済みセクタ(5)が増え続ける場合も同じです。一方、CRC エラー(199)やタイムアウト(188)は、まずケーブル・変換基板・電源を疑います。
smartctl の定期実行は、smartd ではだめですか?
smartmontools 付属の smartd でも、セルフテストの定期実行と異常時のメール通知はできます。この記事のスクリプトは、それに加えて前日との差分、マウント、rsync の鮮度、カーネルログもまとめて見て、Slack に 1 行で出します。
SSD でも同じやり方で大丈夫ですか?
SMART の読み取りと差分比較、セルフテストという考え方は同じです。ただし見る属性が違い、残り寿命や総書き込み量が中心になります。また、badblocks -w のような全面書き込みは寿命を減らすので、SSD にはおすすめしません。
おわりに
バックアップは、「取ること」より「読めること」のほうが難しい。しかも、読めるかどうかは読んでみないと分からない。それなら、読む作業を smartctl と cron に毎月やらせて、兆候は毎晩見ればいい。つまり、やっていることはそれだけです。
最初のフィラデルフィアの事故は、2 本目の回線が切れていたことに、切り替えるまで誰も気づかなかった話でした。そして、机の上の 4 TB にも同じことが起きます。つまり、違いは気づくための仕組みを置くかどうかだけです。