

【インフラ設計×Claude #1】非機能要件をClaudeと策定する
はじめに
プロジェクト概要
新規にクラウド基盤を構築するプロジェクトで、インフラ設計を担当しました。基盤を作る前に、性能・可用性・運用・セキュリティの水準を決める「非機能要件」と、それを満たすための「インフラ構成方針」を固める必要がありました。
このプロジェクトでは、非機能要件が、あらかじめ決まった形では用意されていませんでした。何を、どこまで決めればよいのか、手探りで進めることになります。そこで、公開されている指標を土台にして、決める範囲を絞りながら、要件を組み立てていくことにしました。
前提が少し特殊で、初期フェーズ(小規模・限定的な運用)と本番(大規模・常時運用)では、求める水準が大きく違います。そこで、非機能要件も構成方針書も「初期フェーズを対象に書き、本番は実測を踏まえて別途決める」と割り切りました。また、顧客側の社内標準にも従う必要があります。
この連載について
この作業をClaudeと進めた記録を、全3回でお届けします。
- 第1回(本記事):非機能要件をClaudeと策定する
- 第2回:方針書とADRを分けて書く
- 第3回:Claudeとの役割分担と手戻りの記録
非機能要件を初めて整理する方、設計ドキュメントの作成にAIを使ってみたい方に向けて書いています。なお、顧客を特定できる情報は伏せ、案件固有の内容は一般化しています。
238項目を前にして、何から決めるのか
出発点にしたのは、IPAが公開している「非機能要求グレード」です(現在はIPAのアーカイブページで公開されています)。2018年版の原本は、指標(メトリクス)単位で数えると238項目あります。
非機能要件でよくあるのが、「全項目に値を入れようとして終わらない」「そもそも値を決められる人が手元にいない」という悩みではないでしょうか。今回も手探りで進めることになりました。
最初に決めたのは「誰の責任か」で削ること
クラウド上に基盤を作る場合、機器やデータセンター単位の冗長化、付帯設備、リソースの物理的な拡張性は、クラウド事業者の責任範囲です。これらはクラウド利用者が要件として決めても意味がないため、削除または統合しました。IPAの大項目のうち「移行性」「システム環境・エコロジー」は、全項目を削除しています。
一方で、IPA原本にない観点は追加しました。コンテナ、CI/CD、マイクロサービス、オブザーバビリティなどです。結果として、大項目は「可用性」「性能・拡張性」「運用・保守性」「セキュリティ」の4つ、72項目になりました。
| IPA原本238項目の扱い | 件数 |
|---|---|
| 採用 | 22 |
| 統合(複数項目を1つにまとめたもの) | 111 |
| 削除 | 105 |
| 合計 | 238 |
統合した項目はまとめ直し、さらに新規の25項目を追加して、最終的に72項目の非機能要件になりました。
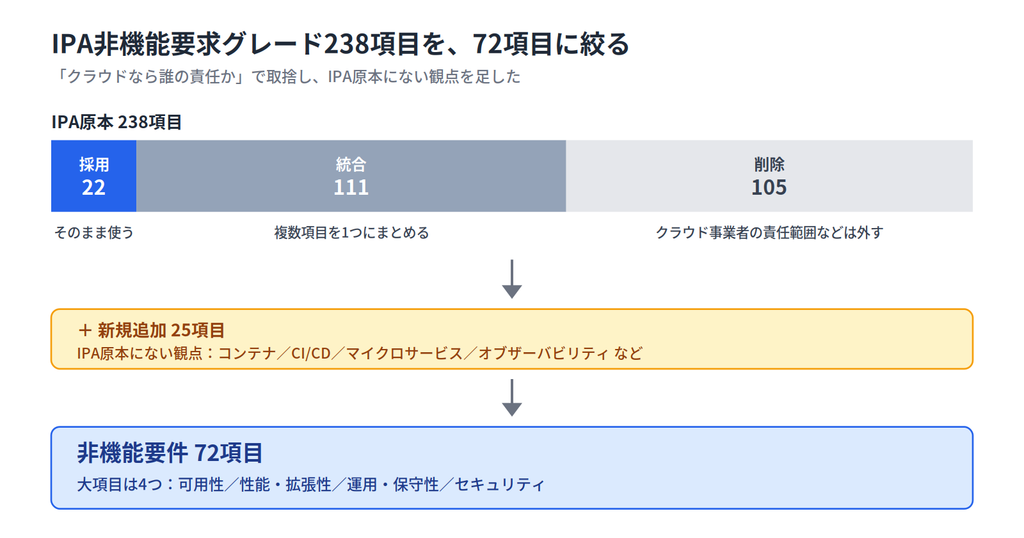
学び①:網羅性を目指すより、「自分たちが決める範囲はどこか」の線引きを先にやる。責任範囲で切ると、削る理由を説明しやすい。
値の決め方:段階を分けて、分類して書く
「常時稼働」の初期案を、コストで段階分けし直した
最初の方針案は、「常時稼働」を前提にした水準に寄っていました。しかし、初期フェーズは小規模で、限定的な運用です。そこでコストを理由に見直し、値を「初期フェーズ」と「本番」の2列に分けて書くことにしました。たとえば運用時間は、初期フェーズは限定的、本番は常時、という具合です。
要件を5種類に分類する
72項目すべてを個別に悩むのは大変なので、各要件に次の分類を付けました。
| 分類 | 意味 | 件数 |
|---|---|---|
| 統一 | 全体で同じ値にする(暗号化方式など) | 35 |
| 階層化 | 重要度に応じて3段階で差をつける(復旧目標、応答時間など) | 18 |
| 分離 | 業務ごとに別の値にする | 7 |
| 固有 | 特定のサブシステムだけの要件 | 8 |
| 依存連動 | 呼び出し先の要件が呼び出し元に伝播する | 4 |
半数近くが「統一」なので、まず全体で1つの値を決めてしまえば、残りは「階層化」と「分離」に集中できます。「依存連動」は呼び出し元に響くため、伝播するパターンを別表にまとめました。
決めきれない論点は、ステータスと確認先で管理する
非機能要件は、すべてが一度に決まるわけではありません。決まっていない項目を放置しないため、次のように管理しました。
- 検討ステータスを3段階にする:完了(主要関係者と整合済み)/条件付き完了(仮整合で、検証により更新あり)/未完了。
- 確認先を3つに区分する:顧客の判断が必要/情報提供の依頼/他チームとの調整。
- トレーサビリティマトリクスで抜け漏れを見る:要件ごとに「設計項目あり/前提条件/対象外」を付けました。
Claudeとの進め方
Claudeに任せたことと、人が決めたこと
| 担当 | やったこと |
|---|---|
| Claude | 質問文の作成、要件と検討項目の対応づけ、集計 |
| 人 | ・IPA項目の取捨(採用/統合/削除)の案と理由付け ・顧客側とのすり合わせや整合 ・AIに入れる情報の取捨、Claudeの出力の正当性の検証 |
指示の工夫:事実と推測を分ける
Claudeには、作業ルールとして次のような指示を、常に読み込ませました。
- 確認できた事実と推測を分ける。推測には「推測」、分からない点は「不明」と書く
- 依頼者の発言のうち、資料で裏が取れないものは「依頼者発言由来・未確認」と書く
- 料金・上限値・対応状況は公式ドキュメントで確認し、URLを付ける
- 結論の前に、その結論が依存する前提を示す
成果と課題
成果
何も決まっていない手探りの状態から、IPA原本の238項目を72項目に絞り、非機能要件として目指すゴールを整理できました。
途中で見つけた問題:出典のない値
順調に進んだ中で、1つだけ印象に残っている問題があります。バックアップを「世代数」で持つ、という要件です。
気づいたのは、後続の設計フェーズで、設計ガイドラインを改めて見直したときでした。ガイドラインの記述と照らすと、要件の記述のロジックが合いません。調べてみると、根拠となる記述は顧客側の社内標準にもなく、クラウド側にも「世代数」を設定する項目がありませんでした。出典のない値が、いつの間にか要件に入っていたことになります。
気づかずに進めていたら、クラウド側で実現できない要件が、方針書まで残っていた可能性があります。対処として、「日数」で管理する形に改め、「世代数」という言葉自体を使わないことにしました。
学び②:根拠のない値は、「誰が書いたか」ではなく「どこに書いてあるか」で消す。出典を示せない値は、AIが書いたものでも人が書いたものでも、同じ扱いにする。そして、書いた時点で気づけるとは限らないので、後の工程で、ガイドラインと照らし直す。
まとめ
経験から学んだ教訓
- 網羅性より先に、「自分たちが決める範囲」の線引きをする。
- 根拠のない値は、誰が書いたかではなく、どこに書いてあるかで判断する。書いた時点で気づけない場合に備えて、後の工程でも照らし直す。
- 決めきれない論点は、ステータスと確認先で管理し、待つものは待つと決める。
今後の展望
今回は、作業時間がどれだけ短くなったかを、比較できる形で記録していませんでした。次の機会には、作業の前後で時間を測り、AI活用の効果を数字で示したいと思います。
次回は、この非機能要件から、構成方針書とADRをどう設計したかを書きます。「今守ること」と「なぜそうしたか」を別のファイルに分けた理由が中心です。
【インフラ設計×Claude #2】方針書とADRを分けて書く


